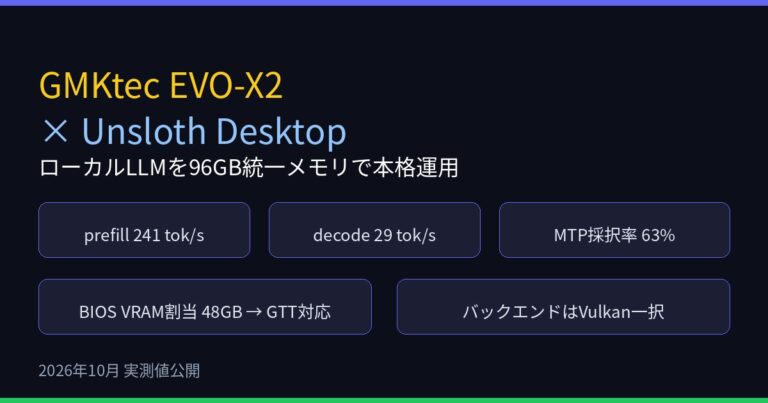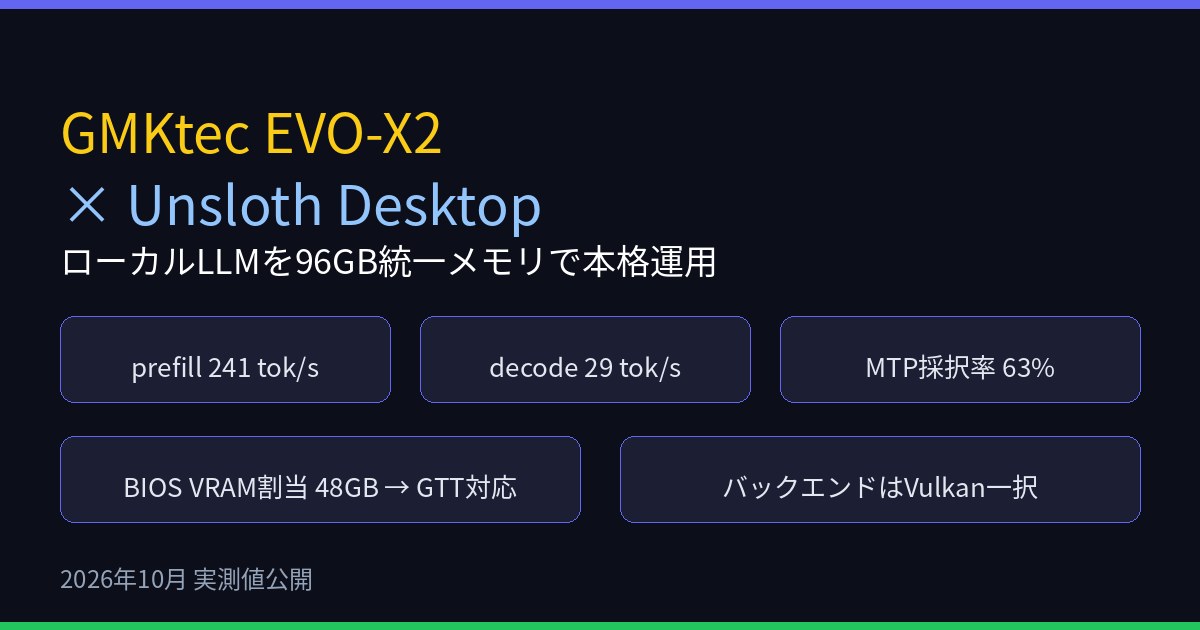
「LLMを自分の手元で動かしたい」——クラウドAPIの料金とプライバシーが気になるようになってから、私が実際にたどり着いた答えが GMKtec EVO-X2(AMD Ryzen AI Max+ 395)× llama.cpp です。この記事は、2026年10月時点で私の部屋で本稼働しているローカルLLM環境の実測値と運用記録です。
なぜローカルLLMなのか
ClaudeやChatGPTのようなクラウドLLMは便利ですが、次の3つが常に付きまといます。
- 料金: 使うたびに従量課金。エージェント的に使い倒すと月数千円〜
- プライバシー: 自分の設定ファイル・家計簿・健康記録を外部に出す不安
- 自由度: モデル差し替え・コンテキスト長・常時稼働がプロバイダ次第
特に私はHermes Agentのような「AIエージェント」を毎日使い倒すので、トークン課金は痛い。そこで2026年5月にローカルLLM専用機を導入しました。
ハードウェア: GMKtec EVO-X2
私が買ったのはGMKtec EVO-X2(2026年5月19日購入、税込337,725円)。中核はAMDのAPU「Ryzen AI Max+ 395」で、ミソはメモリ構成です。
- CPU: AMD Ryzen AI Max+ 395(Zen 5系・32スレッド)
- GPU: Radeon 8060S(RDNA 3.5系、ROCm対応)
- メモリ: LPDDR5X-8000 96GB(ユニファイドメモリメモリ)
- SSD: 1TB、電源は外付けアダプタで本体は超小型・静音
ポイントなのは「VRAM専用メモリ」ではなく「CPUとGPUが共有する96GBのユニファイドメモリメモリ」であること。ただし注意点があって、BIOSでGPU(VRAM)に割り当てられるのは48GBまで。私の運用ではこれをGTT(Graphics Translation Table)側のマッピングで対応して、48GBを超えてモデルを積んでいます。ユニファイドメモリメモリ機だからといって無制限にVRAM扱いできるわけではなく、この辺りは自分の環境に合わせてチューニングが必要です。
そしてこれが今回一番伝えたかったのですが、EVO-X2でLLMを実際に「VRAMに載せる」にはVulkanバックエンド一択でした。ROCm(HIP)ビルドではモデルがGPU側に乗らずCPU推論に落ちて体感が遅い/メモリ統計もおかしい状態で、Vulkan対応のllama.cppビルド(Unsloth Desktop同梱版はVulkan対応済み)に切り替えて初めて、Radeon 8060S経由でユニファイドメモリメモリをGPUメモリとして使い切ってくれます。「APUだからROCmで動いて当然」ではなかったのが実運用での正直な感想です。ROCmで動かせる設定を知っていたら教えてください。
ちなみに私は96GB版を選びましたが、128GB版ならBIOSでVRAM割当を96GBまで設定できるそう。当時は128GB版が20万円ほど高く、96GB版+GTT対応で割り切りました。大規模モデルをVRAM載せ切りの高速推論で回したいなら128GB版、コスト優先なら96GB版。いまは96GB版も高くなっているようです。
ソフトウェア構成: Unsloth Desktop(Ubuntu)
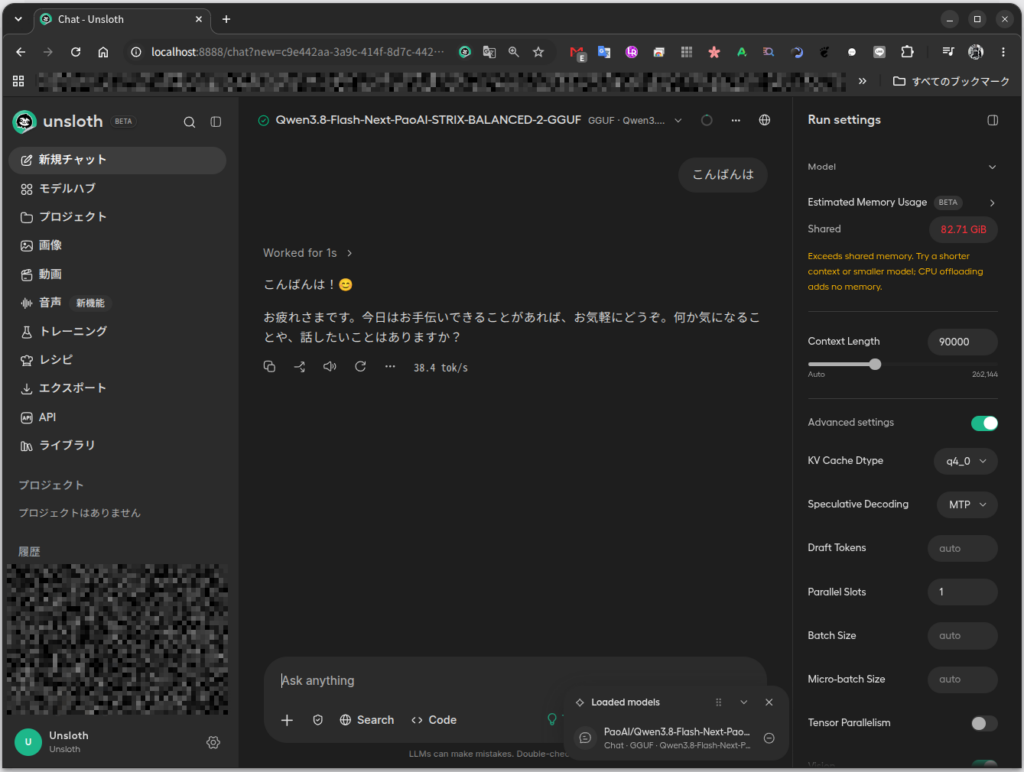
OSはUbuntu(Wayland)。推論環境はUnsloth Desktopを使っています。これはUnsloth Studioのデスクトップ版で、llama.cpp系のビルド(llama-server / whisper.cpp / audio.cpp / stable-diffusion.cpp)が一式同梱され、GUIからモデルのダウンロード・起動・パラメータ管理までできるツールです。すべての機能は使用していません。
中身はllama-serverなのでOpenAI互換APIもそのまま立ちます。私の現在の稼働設定はこんな感じです。
- モデル: Qwen3系 Flash-Next アーキテクチャのコミュニティ調整量子化版(MoE、約131B-A6B級)+ MTPドラフトモデル
- コンテキスト長: 90,000トークン
- KVキャッシュ: q4_0量子化で省メモリ化
- MTP(Multi-Token Prediction)投議デコードを併用し、生成速度を底上げ
- reasoning(思考チェーン)出力対応・Jinjaテンプレート適用
Linux版Unsloth Desktopの利点は、ROCmまわりのビルドを自分で戦わずして入ることと、モデル管理がGUIで楽なこと。一方で細部(reasoning_contentの挙動など)はllama.cpp直運用と同じ癖があるので、APIクライアント側は素のllama-server仕様を意識しておくのが安全です。
実測性能(2026年10月12日、llama-serverメトリクスより)
稼働中のllama-serverから直接取った実測値です。
| 項目 | 実測値 |
|---|---|
| Prefill(読み込み)速度 | 約241 トークン/秒 |
| Decode(生成)速度 | 約29 トークン/秒(MTP投議デコード込み) |
| 投議トークン採択率 | 約63%(78,440中49,834採用) |
| プロンプトキャッシュ命中率 | キャッシュ5.59M / 生291K ≈ 19倍 |
体感としては「生成はChatGPTより少し遅いが読み込みが速い」で、エージェント運用ではプロンプトキャッシュの効率が命になります。同じシステムプロンプトを積み続ける限り実質ほぼ無料・高速でやり取りできるのがローカルの強みです。
運用して分かった落とし穴
- バックエンドはVulkan一択だった: ROCm(HIP)ビルドではモデルがGPUに乗り切らず推論体感がおかしかった。UnslothのVulkanビルド(gfx1151対応版)に切り替えて初めてRadeon 8060Sが仕事した
- BIOSのVRAM割当は96GB版で48GB上限: GPU扱いできる領域はBIOS上48GBまで。私はGTT側マッピングで対応している(ここを詰めて初めて大モデルが積める)。128GB版ならBIOS設定で96GB割当が可能らしい
- thinkingモデルの罠: 思考内容が
reasoning_contentに流れてcontentが空になる実装があり、APIクライアントは両方見る設計にしないと「返事が空」バグの地獄を見る - 常時稼働の電力と熱: 小型機だが負荷時は排熱音あり。デスク裏に置くと温かい
まとめ: ローカルLLMは「買い」か
私にとってEVO-X2導入は大正解でした。33万円は決して安くありませんが、エージェントを月1000万トークン使う生活に変えると、クラウド課金とプライバシー不安からの解放は十分元を取れます。
MACも高額なので、私としては「価格・小型・96GB・Linux」で、購入当時ではEVO-X2系ほぼ一択というのが私の実感です。
そして次なる目標は次期モデル「Qwen4」。ローカルLLMの面白さは、新しいモデルが来るたびに自分の機械がどこまで応えるか試せるゲームみたいなところ。続編を書ける日を楽しみにしています。
※本記事の性能値は2026年10月12日時点、当環境の実測値です。モデル・ドライバ・量子化設定により変動します。
著者について